
제 1편 / 총 3부작
어느 아침 모니터링 모니터 한구석에 띄워둔 전사 인시던트 채널 #incident-p0-alert에 붉은색 경보가 연속으로 찍히기 시작했습니다. 신규 대고객 모바일 앱 리뉴얼과 현장 키오스크 프로모션이 동시에 오픈된 지 불과 이틀째 되던 날이었습니다.
수많은 고객이 동시에 모바일 앱을 켜고 현장 키오스크에서 바코드를 스캔하자마자 시스템은 신음조차 내지 못하고 주저앉았습니다. 고객 화면에는 무한 로딩 인디케이터가 돌았고, 오프라인 매장 결제 단말기는 타임아웃을 뿜어냈습니다. 더 심각한 것은 대고객 채널의 병목이 내부 백오피스와 회계 정산 배치 시스템까지 연쇄적으로 멈춰 세웠다는 점이었습니다.
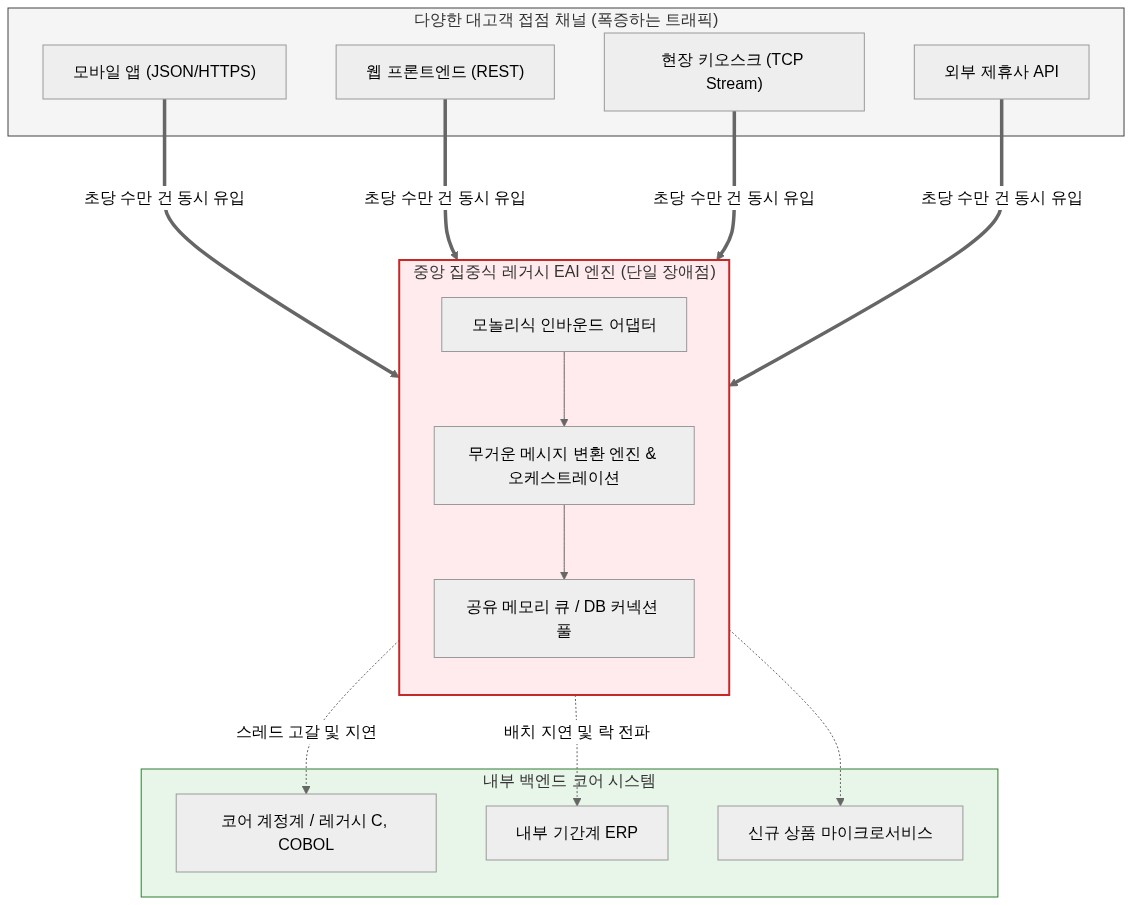
당시 우리 시스템은 엔터프라이즈의 오랜 표준이라 불리던 중앙 집중형 EAI(Enterprise Application Integration) 허브를 통해 대내외 모든 통신을 처리하고 있었습니다. 그날의 장애는 단순한 인프라 스펙 부족이 아니었습니다. “모든 연계는 EAI가 담당한다”는 수십 년 묵은 설계 관성이 대규모 실시간 트래픽이라는 새로운 파도를 맞아 침몰한 순간이었습니다.
* 장애 전파의 위험: 대고객 채널과 백오피스 연계가 단일 EAI 허브를 공유하면, 순간적인 인바운드 스파이크 트래픽이 커넥션 풀을 고갈시켜 코어 계정계와 내부 업무망까지 연쇄 마비시킵니다.
* MCI의 필연성: 채널의 다양성과 폭증하는 트래픽을 흡수하고 코어 백엔드를 보호하기 위해서는 프로토콜 변환, 트래픽 제어, 서킷 브레이커를 전담하는 독립적인 MCI(Multi-Channel Integration) 계층 분리가 불가피합니다.
1. 그 시절 우리는 왜 EAI 하나에 모든 것을 걸었을까?
과거 엔터프라이즈 환경에서 EAI는 만능 은탄환이었습니다. 계정계 코어 시스템, ERP, CRM, 데이터웨어하우스가 복잡하게 얽힌 N:M 스파게티 연결을 단일 허브 앤 스포크(Hub-and-Spoke) 구조로 정리해 준 주역이었기 때문입니다.
당시의 주된 통신 패러다임은 명확했습니다.
1. 트래픽의 발생 지점이 대부분 사내 직원용 단말(Intranet)이거나 정기적인 대량 배치(Batch)였습니다.
2. 트랜잭션의 속도(Latency)보다는 2PC(Two-Phase Commit)나 분산 트랜잭션 기반의 완벽한 데이터 무결성이 최우선이었습니다.
3. 데이터 포맷은 대개 고정폭 전문(Fixed-Length)이나 무거운 XML 구조였고, EAI 엔진은 이 무거운 변환 작업을 중앙 서버의 강력한 컴퓨팅 파워로 묵묵히 소화했습니다.
문제는 세상이 바뀌었다는 점입니다. 스마트폰이 보급되고, 웹 뷰 기반의 하이브리드 앱이 표준이 되었으며, 현장 키오스크와 외부 오픈 API 파트너십이 기하급수적으로 늘어났습니다.
대고객 채널 트래픽은 내부 인트라넷 트래픽과 질적으로 다릅니다. 초당 수만 건의 요청(TPS)이 예고 없이 쏟아지며, 사용자는 200ms만 응답이 지연되어도 새로고침 버튼을 연타합니다. 우리는 이러한 고성능·저지연(High-Concurrency & Low-Latency) 트래픽을 “기존에 잘 돌고 있던 EAI 버스에 채널 어댑터만 하나 더 꽂으면 되겠지”라는 안일한 생각으로 수용했던 것입니다.
2. 장애의 재구성: 스레드 고갈과 캐스케이딩 타임아웃의 악몽
당일 장애가 발생했던 물리적 프로세스를 복기해 보면, 전형적인 리소스 고갈형 연쇄 붕괴 패턴이었습니다.
(1) 무거운 페이로드 파싱과 동기 블로킹(Blocking)
모바일 앱에서 들어오는 JSON 요청과 키오스크에서 유입되는 가변 바이너리 패킷을 수신한 EAI 어댑터는 이를 내부 표준 Canonical XML 포맷으로 변환한 뒤 계정계 고정폭 전문으로 다시 직렬화했습니다. 고작 필드 몇 개를 조회하는 가벼운 트랜잭션이었음에도, EAI 내부 파서 엔진의 CPU 사용률은 90%를 가뿐히 넘겼습니다.
(2) 스레드 풀 고갈과 역압(Backpressure)의 부재
레거시 EAI 엔진은 대개 인바운드 요청마다 전용 작업 스레드를 할당하는 워커 모델(Thread-per-Request)을 사용합니다. 모바일 트래픽이 평소 대비 5배로 튀자, 500개로 지정되어 있던 글로벌 워커 스레드는 순식간에 소진되었습니다. 인입 대기 큐(Wait Queue)는 수천 단위로 밀려났고, 유입 속도를 조절해 주는 스로틀링(Throttling)이나 백프레셔 장치는 작동하지 않았습니다.
(3) 커넥션 락과 도미노 붕괴
EAI 엔진의 작업 스레드들이 코어 DB와 계정계 전문 소켓 응답을 기다리며 블로킹 상태에 빠지자, 채널 트래픽과 전혀 상관없는 내부 회계 전표 처리 배치 작업까지 동일한 커넥션 풀을 확보하지 못해 타임아웃을 냈습니다. 고객 채널의 혼잡이 전사 기간계를 완전히 멈추게 한 것입니다.
3. 현장에서 얻은 오답노트: EAI, MCI, FEP의 경계를 허물었던 대가
장애 복구 회고를 진행하며 뼈저리게 확인한 교훈은, 엔터프라이즈 연계 아키텍처에서 MCI, EAI, FEP 세 영역의 역할과 책임을 명확히 분리하지 않은 대가는 결국 대형 장애로 돌아온다는 점이었습니다.
대규모 시스템에서 세 영역은 다루는 트래픽의 본질부터 다릅니다.
- MCI (Multi-Channel Integration): 대고객 외부 채널(Inbound)과 내부 코어를 연결하는 최전방 관문입니다. 높은 동시성 처리, 초당 수만 건의 TPS 수용, 밀리초 단위의 초저지연 변환, 비동기 논블로킹 I/O, 채널별 유량 제어가 생명입니다.
- EAI (Enterprise Application Integration): 내부 시스템(A2A) 간의 데이터 통합입니다. ERP, SCM, 회계 시스템 등 상이한 내부 패키지 간의 복잡한 프로세스 오케스트레이션과 트랜잭션 데이터의 완전한 동기화가 핵심입니다.
- FEP (Front End Processor): 금융결제원, 카드사, 공공기관 등 대외망(External Network) 전용선 연계 관문입니다. 상대 기관이 규정한 엄격한 표준 전문 프로토콜과 전용 보안 규격을 준수하며 트랜잭션을 엄격히 검증합니다.
우리는 이 세 가지 서로 다른 책임과 성능 요구조건을 단일 솔루션 패키지(EAI)라는 거대한 블랙박스에 구겨 넣고 있었던 것입니다.
레거시 EAI vs 현대적 MCI 아키텍처 비교
| 비교 항목 | 기존 레거시 EAI 중심 구조 | 채널 분리형 MCI 도입 구조 |
|---|---|---|
| 연계 주안점 | 내부 기간계 시스템 간 비즈니스 오케스트레이션 (A2A) | 대고객 접점 채널(모바일/웹/키오스크)과 백엔드 연계 |
| 주요 트래픽 특성 | 중간~낮은 빈도, 트랜잭션 복잡도 높음, 배치 위주 | 초고빈도(High TPS), 극단적인 스파이크, 실시간 응답 필수 |
| I/O 모델 | 동기 블로킹(Thread-per-request), 메시징 큐 기반 | 비동기 논블로킹(Event-driven / Reactive) 기반 |
| 데이터 변환 | 무거운 런타임 XML/Canonical 모델 중심 | 경량 JSON / 바이트 버퍼 기반 고속 스트림 변환 |
| 장애 격리성 | 채널 장애가 백오피스 및 코어 전반으로 전파 (취약) | 서킷 브레이커 및 채널별 격리 풀로 장애 완전 국소화 |
| 스케일 아웃 | 대형 벤더 솔루션 라이선스 한계로 수직 확장(Scale-Up) 의존 | 컨테이너 기반 수평 확장(Scale-Out) 및 유연한 오토스케일링 |
4. 실전 코드 관점으로 보는 안티패턴과 방어벽(Guardrail)
레거시 연계 코드에서 흔히 발견되는 대표적인 안티패턴은, 인바운드 채널의 요청을 백엔드 연결 스레드와 그대로 직결시키고 글로벌 타임아웃과 격리 장치를 누락하는 것입니다.
아래는 실제 현장에서 문제를 일으켰던 전형적인 블로킹 중계 구조와, 이를 프로덕션 레벨에서 최소한의 가드레일을 갖춘 채널 디스패처로 전환하는 구현 예시입니다.
안티패턴: 스레드 블로킹 및 무제한 대기 구조 (Kotlin/Java 계열 의사코드)
개선안: 격리된 타임아웃과 백프레셔를 적용한 디스패처 모델
현대적 MCI 계층의 인바운드 핸들러는 채널별 격리(Bulkhead), 엄격한 레이트 리밋, 논블로킹 타임아웃 가드레일을 갖추어야 합니다.
핵심은 채널의 폭주가 결코 코어 시스템의 생명선(소켓 및 스레드)을 침범하지 못하도록 물리적/논리적 완충 지대를 만드는 것입니다.
5. 시니어 엔지니어가 지금 점검해야 할 체크리스트
만약 여러분의 엔터프라이즈 환경이 새로운 채널 확장을 앞두고 있다면, 시스템 내부가 여전히 레거시 연계 방식의 시한폭탄을 안고 있지는 않은지 다음 항목들을 점검해 보아야 합니다.
- ✓연계 인프라 공유 여부: 모바일, 웹 등 대고객 채널과 ERP, 회계 등 내부 배치 시스템이 동일한 연계 솔루션(또는 동일 브로커 인스턴스)의 리소스를 공유하고 있는가?
- ✓I/O 모델과 스레드 풀 격리: 인바운드 통신이 동기 블로킹 방식으로 코어 백엔드 커넥션과 1:1 결합되어 있는가? 채널별로 스레드 풀/커넥션 풀이 물리적으로 격리되어 있는가?
- ✓종단 간 SLA 타임아웃 체계: 최전방 게이트웨이부터 최후방 레거시 코어까지 단계별로 엄격하게 줄어드는 형태(Descending Timeout)로 설정되어 있는가?
- ✓서킷 브레이커와 역압(Backpressure): 특정 백엔드 서비스가 응답 불능에 빠졌을 때, 수초 내에 해당 통로를 차단하고 인바운드 트래픽에 503/429를 즉시 반환하는 가드레일이 존재하는가?
- ✓메시지 변환 비용: 채널 요청마다 무거운 DOM 파싱이나 복잡한 범용 모델(Canonical Model) 변환을 수행하여 CPU 병목을 초래하고 있지 않은가?
다음 편 예고: 그렇다면 MCI 엔진을 어떻게 바닥부터 설계할 것인가?
대규모 채널 트래픽에서 레거시 EAI가 무너지는 근본적인 이유는 솔루션 자체의 결함이 아니라, 아키텍처의 목적과 트래픽의 형태가 불일치했기 때문입니다.
채널 트래픽의 파고로부터 코어 시스템을 안전하게 보호하면서도, 수만 TPS를 유연하게 소화해 내는 관문은 어떤 모습이어야 할까요?
이어지는 [MCI 아키텍처 #2]에서는 고성능 MCI의 심장부라 할 수 있는 “채널 어댑터 레이어와 고속 프로토콜 중계 엔진 설계”를 다룹니다.
* 비동기 이벤트 루프(Netty) 기반의 대용량 채널 어댑터 파이프라인 구축
* 고정폭 전문(Fixed-Length)과 JSON 간의 무복사(Zero-Copy) 버퍼 변환 전략
* 채널별 동적 라우팅 및 지능형 유량 제어 알고리즘 구현
실제 대규모 분산 차세대 프로젝트 현장에서 검증했던 아키텍처 다이어그램과 프레임워크 설계 코드를 가지고 찾아뵙겠습니다.
현업에서 채널 트래픽 폭증으로 인해 기존 EAI나 레거시 인터페이스에서 겪으셨던 병목 경험, 혹은 현재 MCI 전환 과정에서 고민하고 계신 아키텍처 이슈가 있다면 댓글을 통해 편하게 나눠주세요. 치열하게 고민하는 엔지니어들과의 커피챗은 언제나 환영합니다.
📚 [시리즈 연재 목차] [엔터프라이즈] 대규모 분산 환경을 위한 MCI 아키텍처 실전 가이드
본 포스팅은 총 3부작으로 기획된 테크 시리즈입니다. 아래 목차를 통해 전체 연재를 확인하실 수 있습니다.
- ▶ 제 1편: [MCI 아키텍처 #1] 슬랙 경보가 울렸다: 레거시 EAI 구조가 대규모 트래픽에서 무너지는 이유 (현재 글)
- 제 2편: [MCI 아키텍처 #2] 수백만 트래픽을 관통하는 MCI 핵심 설계 패턴과 FEP와의 명확한 경계 (연재 예정)
- 제 3편: [MCI 아키텍처 #3] 뼈아픈 오답노트: MCI 구축 과정에서 반드시 마주하는 트레이드오프와 실패 방지 체크리스트 (연재 예정)
💡 다음 편에서는 독자들이 가장 궁금해하는 심층 주제를 계속해서 파고듭니다. 많은 기대 부탁드립니다!