
SNAP 배포 초기의 핵심 과제는 엄격한 정확도와 실시간 처리량 사이의 균형입니다. 본 분석은 내재화 모델이 99.9% 일치율이라는 엄격한 기준 아래에서도 프로덕션 피크를 초과하는 부하를 제로 드롭으로 소화하는 메커니즘을 심층적으로 해설합니다.
첫 배포의 딜레마: 99.9% 일치율과 34.74% 커버리지의 의미
SNAP의 첫 배포는 비즈니스 신뢰성을 최우선으로 하여 목표 일치율을 99.9%로 설정했습니다. 검증 요청 100,648건 중 34,963건이 채택되어 coverage는 34.74%로 집계되었으며, 채택된 결과 중 기존 LLM 판단과 불일치한 건수는 34건으로 실제 일치율은 99.9028%를 기록했습니다. 해당 임계값은 예측 불확실성을 효과적으로 필터링하여 오탐을 최소화하는 메커니즘을 보여줍니다. 동일한 기준을 99%로 완화하면 coverage는 51.59%로, 95%로 낮추면 72.35%까지 확대되는 것을 확인할 수 있습니다. 따라서 초기 배포에서는 정확도 타협이 불가능한 환경에서 현실적인 처리 범위가 34.74%로 제한되는 구조적 한계를 명확히 인식해야 합니다.
실무 프로덕션 트래픽 처리량 및 비용 절감 실적 검증
첫 배포 후 약 6일간 동일 상품 판별 작업에서 내재화 모델이 처리한 요청 비율은 일별 약 33~37%로 안정적으로 유지되었습니다. 해당 데이터는 단순한 샘플이 아닌 지속적인 프로덕션 트래픽에서의 실측 데이터이며, 내재화 모델이 LLM의 전체 워크플로우를 대체하지 않고 고신뢰 구간만 선별적으로 처리하는 구조를 반영합니다. 이 기간에 줄어든 LLM Token 사용량은 입력 토큰 약 76억 개, 출력 토큰 약 4,520만 개에 달합니다. 절감 규모는 단순한 비율 계산이 아닌 실제 API 호출 비용과 지연 시간의 직접적인 감소로 이어지며, 고부하 환경에서 내재화 모델이 비용 효율성의 핵심 축으로 기능함을 입증합니다.
| 구분 | 항목 | 수치/스펙 | 실무적 의의 |
|---|---|---|---|
| 운영 기간 | 배포 후 운영 일수 | 약 6일 | 초기 안정성 검증 기간 |
| 처리 비율 | 일별 내재화 모델 처리 비율 | 33~37% | LLM 대체 가능 범위의 현실적 한계 |
| 토큰 절감 | 입력 토큰 절감량 | 약 76억 개 | 대규모 LLM API 비용 감소 |
| 토큰 절감 | 출력 토큰 절감량 | 약 4,520만 개 | 응답 생성 비용의 직접적 절감 |
고부하 서빙 병목 추적: 1,200 TPS 환경에서의 응답 지연 제어
운영 피크인 초당 약 500건을 넘는 598건 처리 구간에서 p50 응답 시간은 7.24ms로 측정되었으며, 해당 수치는 기존 LLM 기반 파이프라인 대비 현저히 낮은 지연을 의미합니다. 더 나아가 실제 처리량이 초당 1,203건인 구간에서도 p50은 9.02ms, p99는 15.23ms였습니다. 모든 테스트 구간에서 실패하거나 드롭된 요청은 없었습니다. 해당 제로 드롭 성능은 단순한 서버 스케일 아웃이 아닌, 요청 분류와 모델 추론의 병렬화, 그리고 메모리 기반 캐싱 구조가 결합된 서빙 아키텍처의 결과입니다. 특히 1,200 TPS 이상의 초고부하에서도 p99가 15ms 이하로 유지된 것은 실시간성 요구가 엄격한 프로덕션 환경에서 내재화 모델이 안정적인 대체재로 기능할 수 있음을 입증합니다.
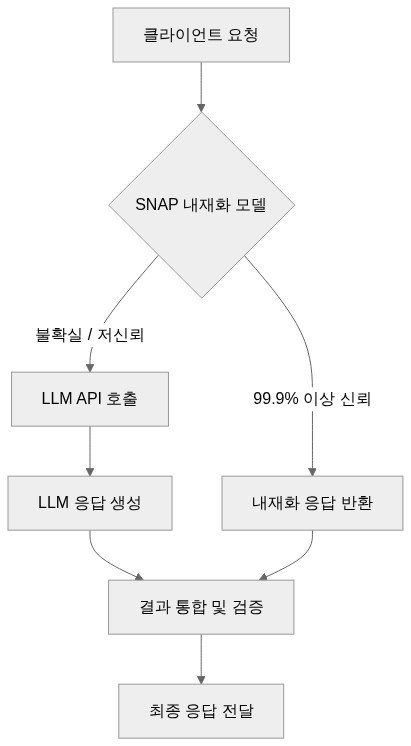
SNAP의 초기 배포는 99.9% 일치율이라는 엄격한 기준 아래 34.74%의 커버리지를 확보했습니다. 해당 결과는 정확도와 범위 사이의 명확한 트레이드오프를 보여줍니다. 6일간의 운영 데이터는 33~37%의 일별 처리 비율과 약 76억 개의 입력 토큰 절감으로 실무적 가치를 입증했으며, 1,203 TPS 부하 테스트는 p99 15.23ms의 제로 드롭 성능으로 서빙 안정성을 확인했습니다. 향후 도입 시에는 목표 일치율을 99%로 조정하여 51.59% 커버리지로 확장할지, 아니면 현재의 99.9% 기준을 유지할지 비즈니스 우선순위에 따라 결정해야 합니다. 실무 엔지니어는 이 데이터를 바탕으로 내재화 모델이 단순한 비용 절감 도구가 아닌, 고부하 실시간 시스템의 핵심 구성 요소로 자리 잡을 수 있음을 인식해야 합니다.
📚 [시리즈 연재 목차] AX 전환 생성형 AI 비용 절감과 엔터프라이즈 에이전트 아키텍처 완벽 가이드
본 포스팅은 총 3부작으로 기획된 테크 시리즈입니다. 아래 목차를 통해 전체 연재를 확인하실 수 있습니다.
- 제 1편: LLM 도입의 딜레마: 핀테크 트래픽 환경에서의 비용과 성능 트레이드오프 분석 ↗
- ▶ 제 2편: 프로덕션 환경에서 마주한 LLM 비용 폭탄: 병목 추적 및 시행착오 회고 (현재 글)
- 제 3편: 손가락 튕기듯 최적화하는 법: 현업 적용 가능한 LLM 비용 절감 액션 플랜 체크리스트 (연재 준비 완료 / 발행 대기)
💡 다음 편 예고: 다음 에피소드 <손가락 튕기듯 최적화하는 법: 현업 적용 가능한 LLM 비용 절감 액션 플랜 체크리스트>에서는 본 편에 이어 실전 프로덕션 최적화와 트레이드오프를 심층 분석합니다. 많은 기대 부탁드립니다!
프로덕션 환경에서 마주한 LLM 비용 폭탄: 병목 추적 및 시행착오 회고 설계, 아키텍처 트레이드오프, 혹은 프로덕션 도입 과정에서 고민이 있으시다면 언제든 편하게 이야기 나눠요. 같은 엔지니어로서 함께 최적의 해법을 고민해 드리겠습니다.